
Retrouvez les mots dans vos PDF numérisés.
Retrouvez un nom, copiez un passage ou recherchez dans un rapport numérisé. TrePDF reconnaît localement l’anglais et le vietnamien et crée un PDF distinct contenant du texte consultable par recherche.
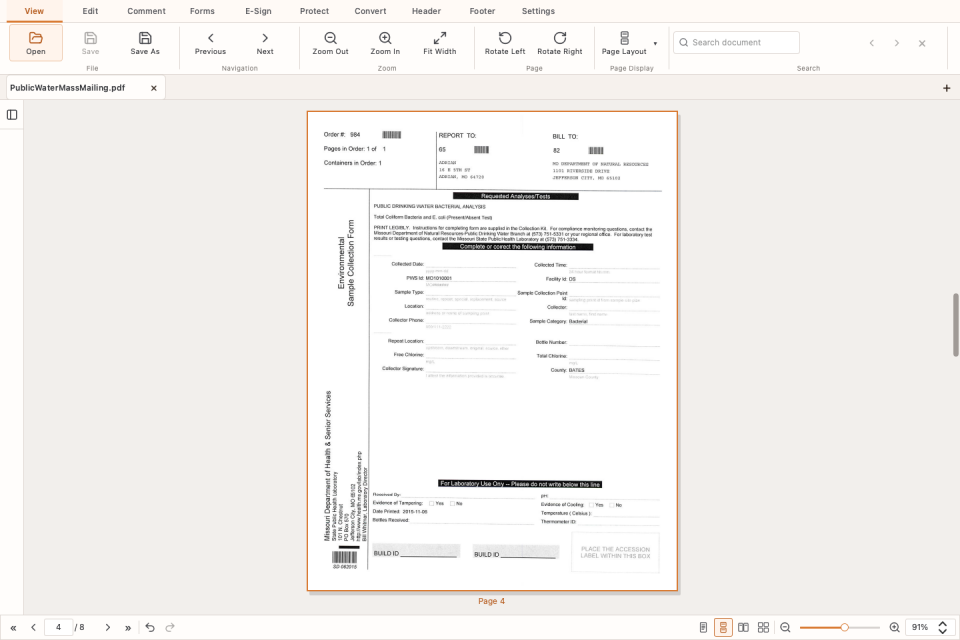
Conservez la page que vous avez numérisée
Les images des pages, les illustrations et les tampons d’origine restent intacts. L’OCR ajoute une couche de texte invisible pour rechercher et sélectionner des mots, tandis que la page visible reste l’image numérisée. La reconnaissance s’effectue sur votre ordinateur, sans envoyer le PDF en ligne.
Créez un PDF consultable par recherche
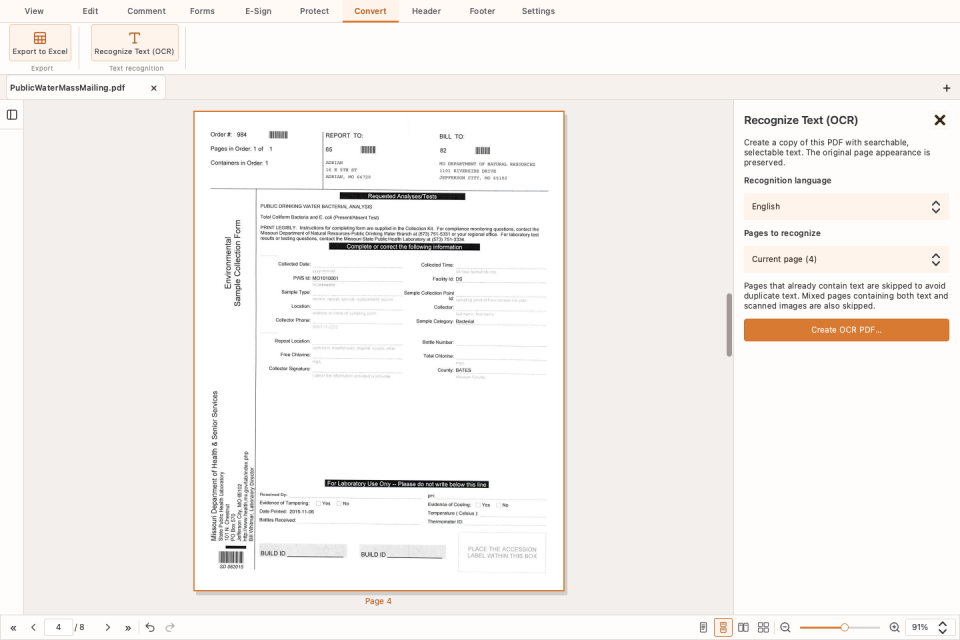
- Ouvrez votre PDF, enregistrez les modifications en cours, puis choisissez Convertir → Reconnaître le texte (OCR).
- Sélectionnez l’anglais ou le vietnamien, puis toutes les pages, la page actuelle ou une plage de pages.
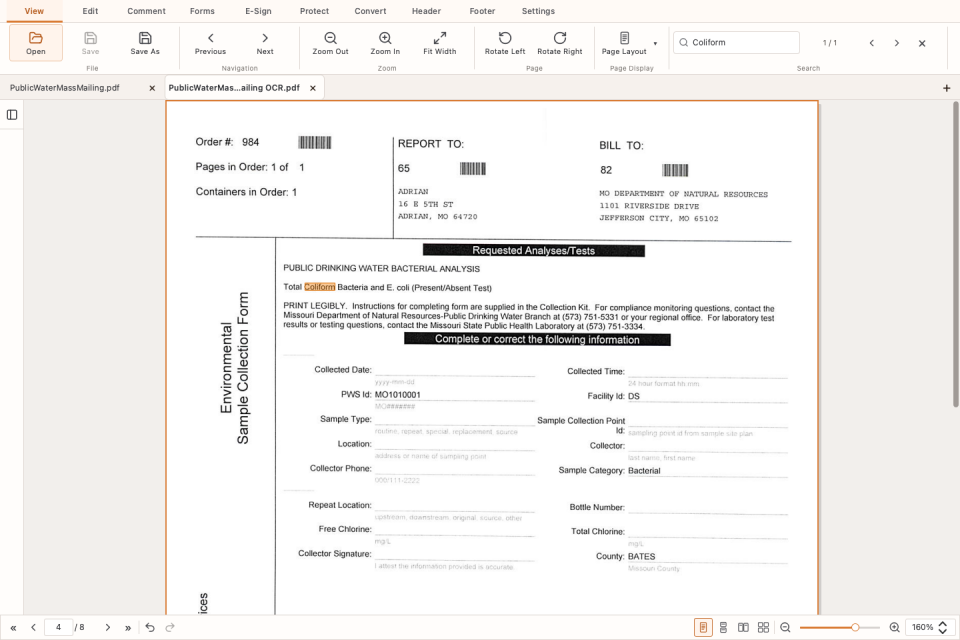
- Choisissez où enregistrer le résultat distinct. Une fois terminé, il s’ouvre dans un nouvel onglet, prêt pour la recherche et la comparaison avec la source.
Évitez les traitements répétés dans les documents mixtes
TrePDF ignore les pages qui contiennent déjà du texte et reconnaît les pages numérisées qui en ont besoin. Une couche de texte existante reste inchangée : l’OCR ne peut donc pas remplacer une reconnaissance inexacte déjà présente dans le PDF.
Vérifiez les mots qui comptent
Les documents numérisés nets et bien droits donnent de meilleurs résultats. Recherchez quelques mots visibles, puis vérifiez les noms, les dates, les nombres et les accents vietnamiens avant de copier le texte. L’OCR permet la recherche dans le document numérisé ; l’image elle-même ne devient pas du texte modifiable.